El conocimiento moral en modelos de lenguaje no se reduce a detectar si un texto habla de moralidad. Un estudio publicado en arXiv en agosto de 2026 (2608.27402) encontró que los modelos de peso abierto organizan ese conocimiento con estructura geométrica. El trabajo está firmado por Orion Reblitz-Richardson, de Distiller Labs. Según el autor, los modelos separan las bases morales entre sí y a la vez las conectan mediante un componente compartido.
La investigación entrenó seis sondas lineales independientes sobre tres modelos de la familia OLMo. Se usaron OLMo-2 1B, OLMo-2 7B y OLMoE-1B-7B, este último de mezcla de expertos. Cada sonda corresponde a una categoría de la Teoría de las Bases Morales. Esas categorías son cuidado/daño, equidad/trampa, libertad/opresión, lealtad/traición, autoridad/subversión y pureza/degradación. Luego se midieron los ángulos entre las direcciones que cada sonda aprende dentro del espacio de representación del modelo.
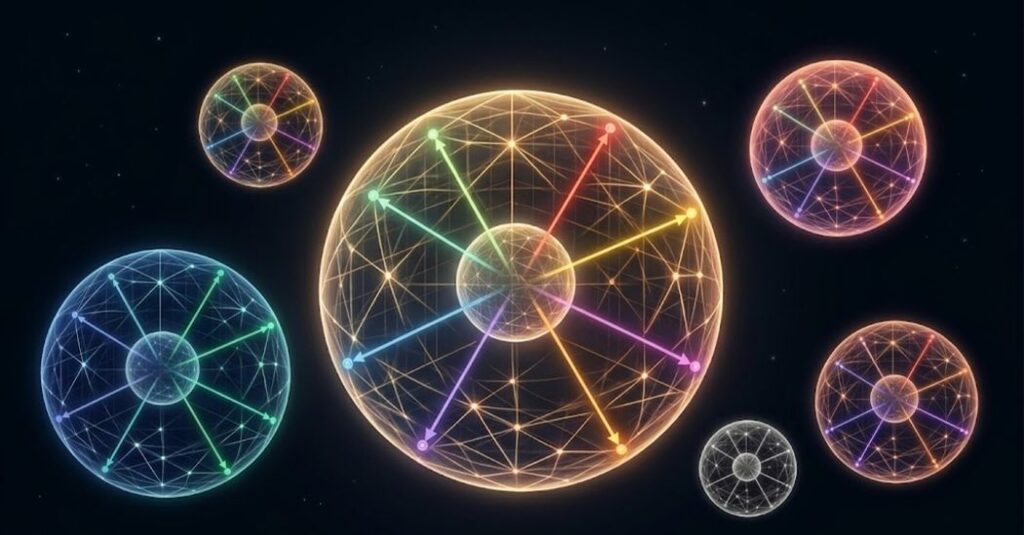
Los autores describen tres modos posibles de representación. En el colapso, todas las direcciones convergen en una sola señal de relevancia moral, que detecta sin distinguir. En el aislamiento, las direcciones son ortogonales, con casilleros separados y sin relación entre ellos. En la integración, las direcciones están separadas pero no son ortogonales. La integración es la forma que adopta el conocimiento moral en modelos de lenguaje. La estructura reemplaza a la detección, y es la condición previa para el razonamiento moral.
Los resultados muestran integración en los tres modelos. Las seis direcciones ocupan cinco dimensiones efectivas en cada capa, lo que descarta el colapso. Su similitud coseno promedio va de 0,22 a 0,27, positiva en todas partes. Contra una batería de conceptos no morales construida de forma idéntica, ese componente compartido resulta unas veinte veces mayor: 0,26 frente a 0,013. La estructura aparece temprano en el preentrenamiento y se estabiliza antes de que la precisión de las sondas sature.
La geometría del conocimiento moral en modelos de lenguaje
El estudio no encontró evidencia de la distinción entre bases individualizantes y vinculares que predice la teoría psicológica. El agrupamiento jerárquico no recupera esa partición en ninguna capa. La estructura más consistente que forma el modelo es un par cuidado-pureza que cruza los grupos teóricos. Según los autores, el modelo descubre qué conceptos morales están relacionados por su distribución en el corpus. No replica la taxonomía humana previa.
La extensión a dilemas morales refuerza la lectura. Con quince dilemas de dos bases en conflicto, las sondas alcanzan 94,2% de precisión media. La dirección de cada dilema se compone parcialmente desde sus dos bases componentes. Ese nivel es 2,7 veces mayor que una línea base de pares no emparejados. La mayor parte de la varianza codifica estructura específica del conflicto. Conforme a la interpretación del autor, el modelo representa la tensión moral misma, no un juicio pre-resuelto.
La prueba de fragilidad mostró un efecto uniforme. La dilución de la salida degrada las seis bases por igual. Ninguna resulta sistemáticamente más frágil dentro de una arquitectura. Entre arquitecturas, todas las bases son unas 2,3 veces más frágiles en el modelo de mezcla de expertos que en el denso.
Un mapa del conflicto, no un veredicto
Un sistema que representa la tensión moral sin resolverla no entrega veredictos. Entrega el mapa del conflicto y deja la resolución en manos de quien decide. Para la colaboración, la parte mecánica de la evaluación moral puede delegarse. El juicio sobre el conflicto sigue siendo una decisión que alguien firma.
El método, además, es general. Los autores prevén aplicarlo a otras taxonomías de valores, a la orientación política y a la organización interna del entrenamiento de seguridad. La pregunta práctica queda abierta: quién carga con la firma de la decisión cuando un sistema muestra el conflicto y no el veredicto.